Gigantes da IA prometem solução para evitar uso de conteúdo de mídia para treinar modelos / foto: ANDREJ IVANOV - AFP
 Elon Musk ironiza derrota republicana após forte apoio financeiro a Trump
 Abdul El-Sayed torna-se primeiro muçulmano eleito para o Senado dos EUA
 Trump atribui derrota republicana à guerra no Irão e aceita resultado eleitoral
 Manifesto de quase 50 personalidades recoloca habitação no centro do debate
 Pedro Duarte condena intervenção policial contra manifestantes no Porto
 Ordem dos Advogados contesta limite horário e atuação policial em protestos
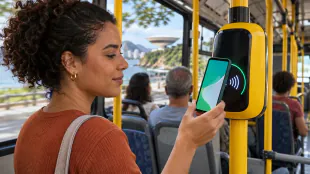 Niterói testa pagamento por Pix em três linhas municipais de ônibus
 Futebolista espanhol morre após colisão com guarda-redes durante jogo
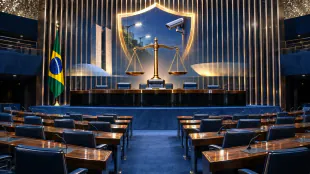 Senado aprova PEC da Segurança Pública sem baixar maioridade penal
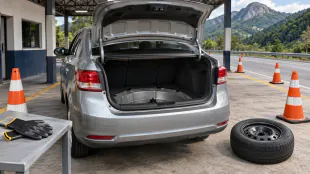 PRF detém homem com drogas escondidas no estepe de carro em Petrópolis
As gigantes da inteligência artificial (IA) prometeram nesta sexta-feira oferecer aos veículos de comunicação e a outros sites uma solução para impedir que seu conteúdo seja extraído para treinar seus modelos, em um contexto de disputa judicial com parte da imprensa.
Atualmente, os editores precisam acionar vários comandos de bloqueio para cada robô que rastreia a web para coletar dados. A solução proposta permitirá que eles insiram uma única instrução padronizada, que será reconhecida e respeitada pelas empresas de IA que adotarem esse protocolo.
OpenAI, Google, Microsoft e Anthropic se somaram à iniciativa, mas a solução só entrará em vigor daqui a alguns meses. A Microsoft vai implementá-la a partir de 1º de fevereiro de 2027, e o Google, em algum momento do ano que vem. Já a OpenAI informou que vai adotá-la nos próximos meses, enquanto a Anthropic afirmou que já começou a fazê-lo.
O anúncio foi feito no momento em que os editores enfrentam um aumento no número de robôs que extraem seus artigos para alimentar modelos de IA. Alguns veículos, como o jornal The New York Times, levaram o assunto à Justiça.
A nova configuração será aplicada apenas ao treinamento futuro de modelos, mas não impedirá que os robôs façam o rastreio de outra forma.
Segundo a Microsoft, a extração de conteúdo será permitida por padrão, a menos que o editor altere essa configuração. A empresa e o Google afirmaram que essa escolha não vai afetar a presença dos sites em suas ferramentas de busca.
O.M.Souza--AMWN